Pipette のご紹介:オンデバイスインテリジェンスのためのベンチマークスイート
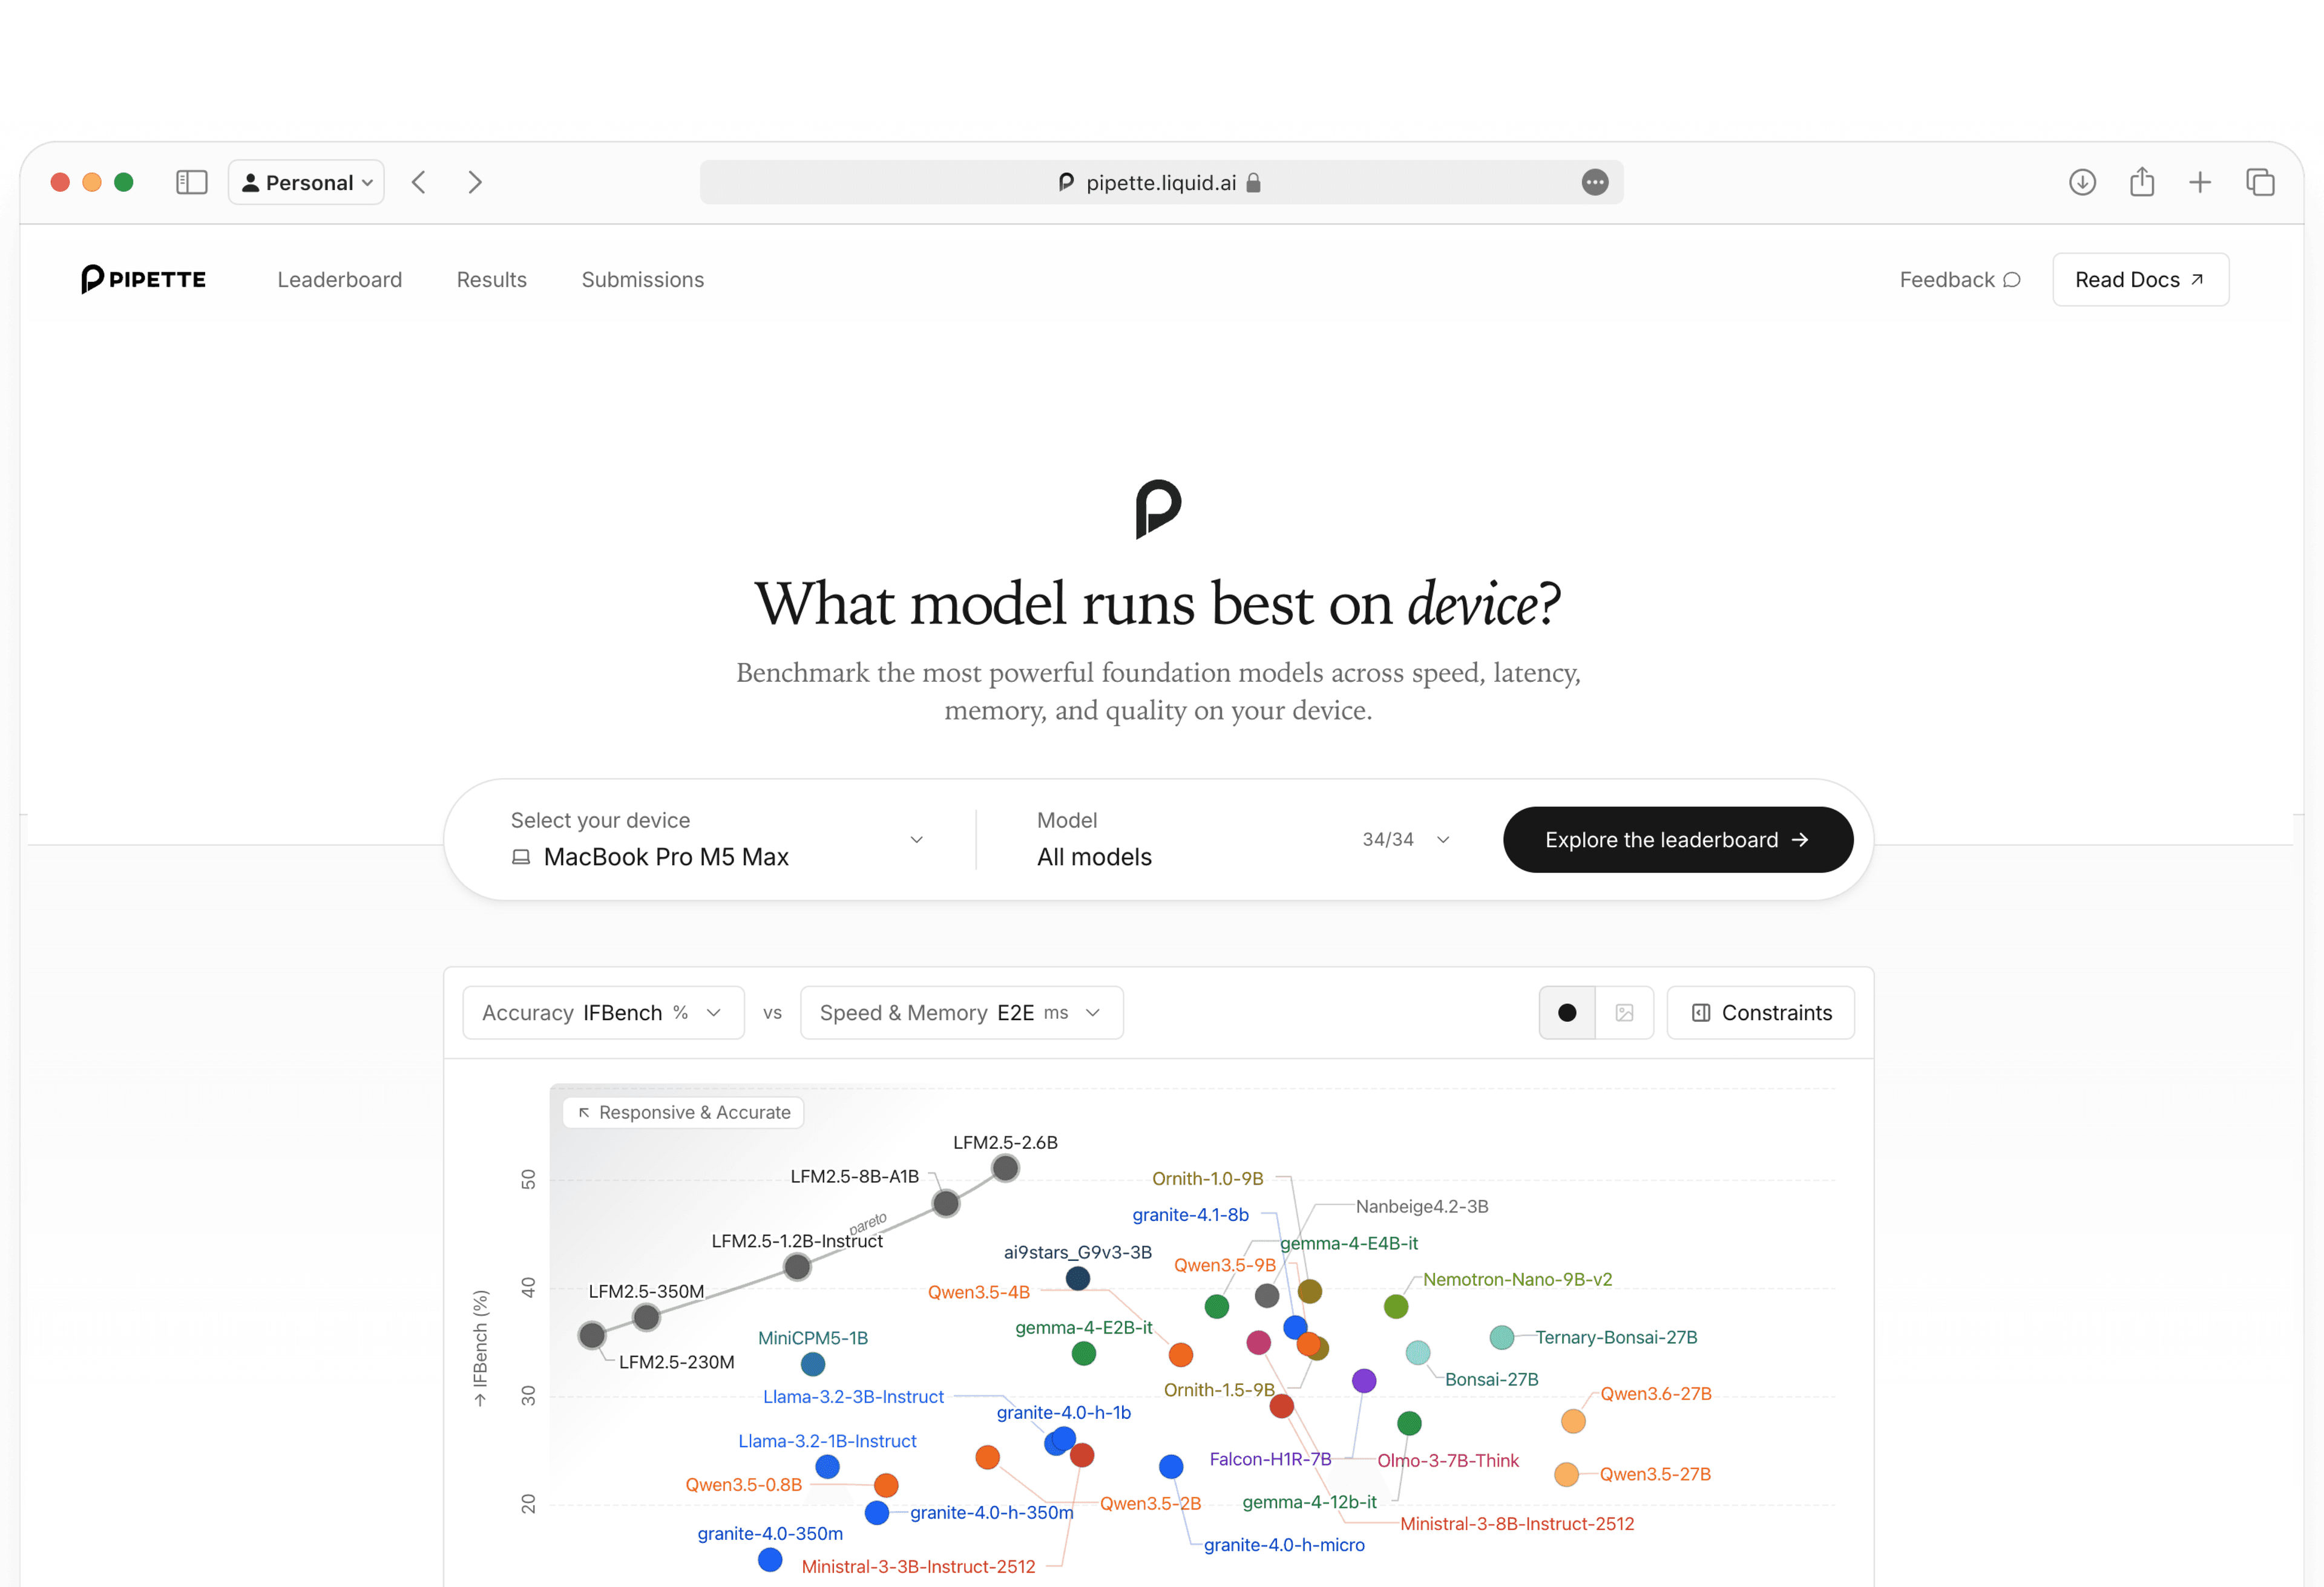
本日、Artificial Analysis との提携のもと、エッジデバイス上で基盤モデルをベンチマークするためのオープンソースプラットフォーム Pipette をリリースしました。Pipette は、「オンデバイスでの挙動はモデル単体ではなく、デプロイされたシステム全体の特性である」というシンプルな前提に基づいて構築されています。エッジへのデプロイを実証的なシステムの問題として捉え直し、実環境での挙動を左右する相互作用を可視化し、検証可能にします。
本日リリースする内容は次のとおりです。
- 公開された再現性プロトコルのもとで生成された、ラボ検証済みの結果からなる公開データセット。モデル × 量子化 × ランタイム × デバイス × コンテキストの 1,000 以上の構成について、5 つのオンデバイス性能指標を収録しています。現在のデータは、30 以上のモデル、複数の量子化フォーマット、macOS、iOS、Windows、Android 向けの llama.cpp ビルド、256〜8,192 トークンのコンテキスト長をカバーしています。初回公開の結果は M5 Max 搭載の MacBook Pro、iPhone 17 Pro、Galaxy S26 Ultra を対象としており、AMD Ryzen AI Max+ 395 と Radeon 8060S の結果も近日公開予定です。カバー範囲の詳細はこちらをご覧ください。
- macOS、Windows、iOS、Android 向けのオープンソースベンチマーククライアント。ターゲットデバイス上で直接パフォーマンスベンチマークを実行するための、ネイティブの iOS アプリと Android アプリも含まれます。コミュニティから提出された結果の公開は、現在ベータ版として提供しています。
- デプロイ構成を分析するためのインタラクティブなダッシュボード。対応デバイスにおける品質評価と、実測したスループット、レイテンシ、コンテキストスケーリング、メモリ使用量を結び付けて確認できます。さらに多くのモデルの追加もすでに進めています。
- Artificial Analysis は、Pipette のオンデバイス性能データと、実際のモバイル利用を代表するよう選定され、均等に重み付けされた品質評価を組み合わせています。
- ベンチマークパイプライン全体を運用するための、Apache 2.0 ライセンスのインフラストラクチャ。リリースには pipette-mgmt、pipette-clients、pipette-scores が含まれます。
 リーダーボードを見る
 GitHub でクライアントを見る
 Artificial Analysis のモバイルベンチマーク結果を見るモデル、ランタイム、プロセッサ、デバイスの追加をリクエスト
モデルのリリース時には、サーバークラスの環境とフル精度の条件で算出された能力スコアが併せて公開されるのが一般的です。こうした結果は有用なベースラインになりますが、想定するデプロイ環境でモデルがどのように動作するかを必ずしも予測するものではありません。オンデバイスでのデプロイには、モデルがメモリに収まるかどうか、どれだけ速く応答できるか、特定のプロセッサ上でランタイムがどう振る舞うかといった、異なる制約が伴います。
Pipette は、バージョン管理されたベンチマーク定義と、再現性を重視して設計された公開測定プロトコルによって、これらの問いに応えます。
デバイス規模のモデルの真の性能を把握するには、能力、速度、レイテンシ、メモリ、ランタイム、プロセッサやデバイスの種類といった多くの次元に、同時かつ慎重に目を向ける必要があります。既存のベンチマークスイートの多くは、これを捉えきれていません。データセンターの外にあるモバイルデバイス、ランタイム、量子化プロファイル、デバイスの状態、ベンチマーク環境は多種多様であり、デバイスクラスのモデルを対象に偏りのない公平なベンチマークスイートを設計するのは容易ではありません。だからこそ私たちは Pipette を構築してオープンソース化し、独立した専門の検証機関である Artificial Analysis と提携して、手法と結果の公平性と再現性を大規模に担保することにしたのです。
オンデバイスベンチマークにデプロイのコンテキストが必要な理由
モデルカードは通常、元のフル精度の重みでの品質を報告しますが、オンデバイスのデプロイでは量子化されたアーティファクトが使われることがよくあります。量子化は出力品質に影響を与えることがあり、その影響はモデル、フォーマット、タスクによって異なります。Pipette は量子化されたアーティファクトを IFBench、GPQA Diamond、MATH-500 で評価し、利用可能な場合は FP16 または BF16 の結果を基準とします。これにより、基準となるアーティファクトで評価された能力が、量子化後にどの程度維持されているかが明らかになります。
Pipette では、すべての測定がテスト済みのデプロイ構成から始まります。
モデル + 量子化 + ランタイム + デバイス
次に、ベンチマークが測定対象の指標とトークン形状を定義し、その構成におけるレイテンシ、スループット、またはメモリの結果を生成します。品質結果は、モデル、量子化、評価バージョン、思考モード、評価の実施主体によって個別に識別されます。現在公開されている品質スコアは、NVIDIA H100 80GB リファレンスシステム上での llama.cpp による評価実行から得られたものです。ダッシュボードでは、これらの品質値が対応するオンデバイス性能の測定値と組み合わせて表示されます。
クラウドでのデプロイでは、多くの場合、容量を追加したり、ワークロードをより大規模なハードウェアや特化型のハードウェアに移したりできます。一方、小規模言語モデルはスマートフォン、ノート PC、組み込みデバイス上で動作し、メモリに収めるためにカスタマイズや特化、大幅な量子化が施されることも少なくありません。そのため、ランタイムの挙動、プロセッサのアーキテクチャ、メモリ負荷、電源状態、熱的な余裕によって、どの構成が実用的かが左右されることがあります。
データからは、こうした相互作用がデプロイの判断をいかに大きく左右しうるかがわかります。
同じ 350M のモデルでも、コンテキストに対するスケーリングは大きく異なることがあります。Galaxy S26 Ultra 上の Q4_K_M では、入力トークンを 256 から 4,096 に増やした際、Granite-4.0-H-350M はデコードスループットの 78.4% を維持する一方、Granite-4.0-350M は 33.8% しか維持できません。Granite のコンテキストスケーリングを比較する
スパースな活性化は、小規模モデル並みの速度をもたらす一方で、メモリ使用量まで小規模モデル並みになるわけではありません。Galaxy S26 Ultra で入力 2,048 トークンの場合、LFM2.5-8B-A1B のデコード速度は Qwen3.5-4B の 2.4 倍、Ministral-3B-Instruct-2512 の 2.6 倍です。トークンあたり 8.5B のパラメータのうち 1.5B しか活性化しないにもかかわらず、すべてのエキスパートの重みがモデルのメモリ要件に含まれるため、ピーク時のメモリ使用量は 5.29 GiB に達します。スパース構成と密な構成を比較する
同程度のサイズの 2 つのモデルを iPhone で比べると、速度と品質のどちらを取るかという選択が浮き彫りになります。Q4_K_M において、MiniCPM5-1B は入力 2,048 トークン・出力 256 トークンのワークロードを 3.47 秒で完了します。LFM2.5-1.2B-Instruct の 4.12 秒と比べ、所要時間は 15.8% 短くなります。一方、同じ Q4_K_M アーティファクトの品質評価では、LFM が MATH-500 で 9.0 ポイント上回ります。どちらの構成も、両方の軸で優位に立つわけではありません。iPhone のパレート比較を開く
ほぼ同一の 8B デプロイプロファイルの裏に、タスクレベルでの逆転が隠れていることがあります。M5 Max 上の Q4_K_M、入力 2,048 トークンの条件では、Granite-4.1-8B と Ministral-3-8B-Instruct-2512 の差は、デコードスループットでわずか 2.4%、ピーク RAM で 1.2% です。しかし同じ Q4_K_M アーティファクトの品質評価では、IFBench で Granite が 7.3 ポイント上回る一方、GPQA Diamond では Ministral が 14.0 ポイント上回ります。性能とタスク品質を比較する
Pipette は、デプロイへの適性を単一のランキングに集約するのではなく、こうしたトレードオフを切り分け、検証可能な形で示します。
Pipette の仕組み
Pipette は再現性と透明性を軸に設計されています。パフォーマンスベンチマークは Pipette の公開された測定手法に従います。タイミングとメモリの測定では、固定のトークン形状、貪欲デコーディング、結果から除外するウォームアップ、5 回の測定反復、レディネスゲーティングを用います。Pipette の手法は Artificial Analysis によるレビューと検証を受けています。評価は、標準データセット、リファレンスランナーによる completion 生成、決定論的かつモデルブラインドな採点を用いる別途公開されたプロトコルに従います。
パイプラインは、次の 3 つのオープンソースコンポーネントで実装されています。
- pipette-mgmt:バージョン管理されたベンチマークカタログを提供し、ベンチマークの提出データを取り込みます。
- pipette-clients:ターゲットデバイス上でベンチマークを実行し、評価用の completion を生成します。
- pipette-scores:評価用プロンプトを提供し、生成元の情報にアクセスすることなく completion を採点します。
クライアントは pipette-mgmt からバージョン管理されたベンチマーク定義を取得し、ターゲットデバイス上で推論を実行します。クライアントは性能の測定値を直接 pipette-mgmt に返します。計時対象の各反復の前には、プラットフォーム固有のレディネスチェックによって、温度と負荷の状態が許容範囲内であることを確認します。Pipette は、このチェックに合格した実行の結果のみを公開します。スマートフォンの電源および冷却条件は、デバイス条件に関する手法に記載しています。
評価については、pipette-mgmt が生成された completion を pipette-scores に転送してモデルブラインドで採点し、そのスコアを生成元の情報とともに保存します。各提出には、ベンチマークとトークン形状、モデルアーティファクトと量子化、ランタイムのバージョンと設定、デバイスのハードウェアと OS が記録されます。Pipette はこのメタデータを用いて、異なる条件下の結果を区別し、各比較の根拠を明示します。現在の結果をどう解釈すべきかについては、文書化された対象範囲と測定上の境界で説明しています。
Pipette の提出データを確認するダッシュボードの中身
ダッシュボードは、相互に補完し合う 3 つの画面で構成されています。デプロイの判断に役立つデバイスごとのリーダーボード、構成レベルの表を表示する結果エクスプローラー、基になるレコードを確認できる提出ブラウザです。いずれの画面でも、モデル、量子化、ランタイム、デバイス、ベンチマーク、コンテキスト長、さらに該当する場合は思考モードでデータを絞り込めます。
実際の制約下でのパレートフロンティア。IFBench、GPQA Diamond、MATH-500 のスコアを、最初のトークンまでの時間、エンドツーエンドのレイテンシ、プリフィルスループット、デコードスループット、ピーク RAM に対してプロットできます。同じモデルの量子化バリアントは線で結ばれ、制約パネルでは品質やスループットの最小値、レイテンシやメモリの最大値で結果を絞り込めます。
コンテキストスケーリングと量子化のトレードオフ。専用ビューでは、モデルをパラメータ規模ごとにグループ化し、256〜8,192 トークンのコンテキスト長にわたるスループットとメモリの推移を追跡し、速度とピーク RAM の関係をマッピングします。量子化ビューでは、各アーティファクトの評価スコアを、利用可能な場合はフル精度の基準値と比較します。
生レコードまでのトレーサビリティ。結果ページには、公開されている各モデル、量子化、デバイス、ランタイムの構成が一覧表示されます。提出ページでは、ベンチマークのバージョン、トークン形状、測定値、そして該当する場合は標準偏差など、それらの結果の基になるレコードを公開しています。カバレッジエクスプローラーでは、ランタイム、デバイス、量子化、ベンチマーク、モデルごとに、どれだけの提出データが含まれているかを確認できます。
共有・文書化・バージョン管理に対応。リーダーボード上の各チャートでは、フィルター設定を保持した共有リンクを生成できます。ドキュメントでは、測定手法、ベンチマーク定義、評価プロトコル、用語集を解説しています。レコードには、各結果がどのように生成されたかを監査するために必要なクライアントとランタイムのバージョンが保持されています。実装の詳細やセットアップ手順については、GitHub の pipette-mgmt、pipette-clients、pipette-scores をご覧ください。
制約と今後の方向性
Pipette はまだ始まったばかりです。Liquid AI のデバイスラボを通じてカバー範囲を拡大しており、提出ワークフローの成熟に合わせて、コミュニティから提供された構成も加えていく予定です。
NPU:NPU のサポート状況は、モデルごとのカーネルおよびオペレーターのカバレッジに依存します。今回の初回リリースでは、公開しているモデル群を十分にサポートし、モデルクラス間で一貫した比較を行える NPU パスが存在しないため、NPU の結果は含めていません。現在このカバレッジの拡大に積極的に取り組んでおり、ハードウェアおよびランタイムのパートナーからのコントリビューションを歓迎しています。
Android GPU のカバレッジ:現在のベンチマーク設定とモデルのカバー範囲では、Android でテストした安定版 GPU バックエンドのいずれも、モデル群全体にわたって、選択した CPU パスを一貫して上回ることはありませんでした。そのため、現在の llama.cpp の Android パスは CPU 中心の構成とし、iPhone のパスでは Metal バックエンドを使用しています。
デバイス間の比較:現時点では、デバイス間の結果を、条件を統制したハードウェア比較として解釈することは推奨していません。Android と iOS の実行では、flash attention のサポート、スレッド数、アクセラレータの使用、実行環境が異なります。Android では CPU ベースの CLI パスで実行される一方、iOS ではアプリ内で Metal を使って実行されます。現在の Pipette の結果は、同一デバイス内で構成を比較する場合に最も信頼性があります。
デバイスクラスのアプリケーション向け品質評価:現在のスイートは指示追従、科学的推論、競技数学をカバーしていますが、エージェント的な挙動、知識集約型タスク、マルチモーダルなワークロード、その他のデバイス向けユースケースを網羅するものではありません。今回のリリースでは、Artificial Analysis が実際のモバイル利用を代表するよう選定された一般的な評価の平均を報告しています。オンデバイスモデルの品質をより適切に表すために、どの能力やベンチマークを含めるべきかについて、フィードバックをお待ちしています。
利用を開始する
Pipette ダッシュボードを開いて、ターゲットとするデバイス上でモデル、量子化、ランタイム、コンテキスト長を比較してみてください。フィルターを適用した各チャートには共有可能な URL があるため、個々のデプロイ比較をそのまま確認し、議論できます。
オープンソースのクライアント、ネイティブの iOS アプリ、Android アプリを使って、お手持ちのハードウェアで Pipette を実行できます。コミュニティから提出された結果の公開は現在ベータ版です。モデルプロバイダー、ランタイム開発者、ハードウェアチーム、アプリケーション開発者の皆さまには、ぜひこのワークフローのテストにご協力いただければ幸いです。
必要なモデル、ランタイム、デバイス、ベンチマークが見当たらない場合は、issue を作成するか Liquid AI にお問い合わせいただき、追加のリクエストやフィードバックをお寄せください。測定と公開のプロセスを完了した構成から、順次追加していきます。
付録
Pipette のローンチ時点で対応しているモデルと量子化フォーマットは以下のとおりです。
LFM2.5-230M:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
LFM2.5-350M:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
LFM2.5-1.2B-Instruct:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
LFM2.5-2.6B:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
LFM2.5-8B-A1B:Q4_0、Q4_K_M、Q5_K_M。Hugging Face
Qwen3.5-0.8B:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Qwen3.5-2B:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Qwen3.5-4B:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Qwen3.5-9B:Q4_K_M。Hugging Face
Qwen3.5-27B:IQ1_M。Hugging Face
Qwen3.6-27B:IQ1_M。Hugging Face
Gemma 4 E2B Instruct:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Gemma 4 E4B Instruct:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Gemma 4 12B Instruct:Q4_K_M。Hugging Face
Granite 4.0 350M:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Granite 4.0 H 350M:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Granite 4.0 H 1B:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Granite 4.0 H Micro:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Granite 4.1 8B:Q4_K_M。Hugging Face
Ministral 3 3B Instruct 2512:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Q4_0 のソース。Q4_K_M、Q5_K_M、Q8_0 のソース
Ministral 3 8B Instruct 2512:Q4_K_M。Hugging Face
Llama 3.2 1B Instruct:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Llama 3.2 3B Instruct:Q4_0、Q4_K_M、Q5_K_M、Q8_0。Hugging Face
Falcon-H1R-7B:Q4_K_M。Hugging Face
Olmo-3-7B-Think:Q4_K_M。Hugging Face
Ornith-1.0-9B:Q4_K_M。Hugging Face
Ornith-1.5-9B:Q4_K_M。Hugging Face
Nanbeige4.2-3B:Q4_K_M。Hugging Face
Ling-3.0-tiny:Q4_K_M。Hugging Face
MiniCPM5-1B:Q4_K_M。Hugging Face
NVIDIA Nemotron Nano 9B v2:Q4_K_M。Hugging Face
ai9stars G9v3 3B:Q4_K_M。Hugging Face
Bonsai-27B:Q1_0。Hugging Face
Ternary-Bonsai-27B:Q2_g64。Hugging Face